羞羞视频亚洲-校园春色av-免费的黄色av-精品乱码久久久久久中文字幕-欧美体内she精高潮-欧美hdse-免费看的黄色小视频-日韩无-国产原创91-高清国产午夜精品久久久久久

技術(shù)解讀丨RoboDual:行業(yè)首款通用具身操作的雙系統(tǒng)協(xié)同框架誕生 發(fā)布時間:2024-10-22 13:00:00


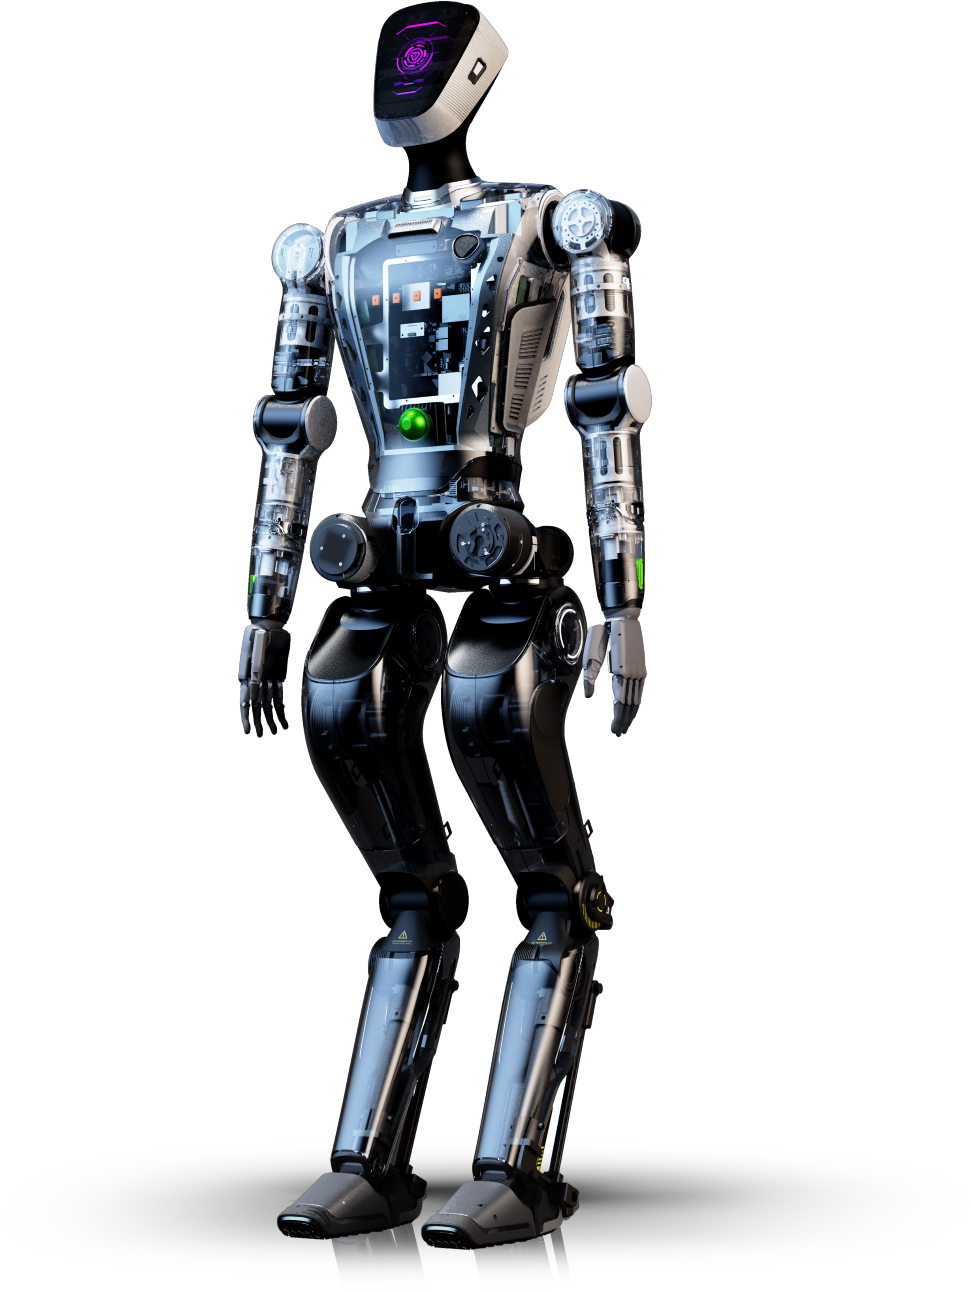
        近日,星空真人機器人攜手上海人工智能實驗室成功打造了行業(yè)首款通用具身操作的雙系統(tǒng)協(xié)同框架——RoboDual。


        這一創(chuàng)新成果將Generalist(通才)的廣泛適應(yīng)性也就是泛化能力,和Specialist(專才)的高效精準性完美融合,顯著增強了機器人操作的靈活性和準確性。


        在傳統(tǒng)的具身智能機器人系統(tǒng)中,“大腦”負責(zé)環(huán)境理解、任務(wù)規(guī)劃和決策,推理能力出眾但實操效率不高;而“小腦”則專注于運動規(guī)劃和控制,操作能力強但泛化能力有限。兩者通常各自為戰(zhàn),難以實現(xiàn)協(xié)同作業(yè)。


        星空真人機器人與上海人工智能實驗室創(chuàng)新性地研發(fā)出RoboDual雙系統(tǒng)協(xié)同框架,利用“小腦”低延遲、高精度、訓(xùn)練高效的優(yōu)勢來彌補“大腦”實操效率低下的不足。該框架直接部署在機器人邊緣側(cè)進行高效推理,“大小腦”交替執(zhí)行任務(wù)。這種設(shè)計不僅提高了操作精度和降低了延遲,還大幅提升了場景和指令的泛化能力。同時,在單個任務(wù)或場景的微調(diào)上也更加高效,并在各項常見評測指標上超越了通才和專才模型。


        下面讓我們一起看下RoboDual系統(tǒng)的技術(shù)表現(xiàn)。


        構(gòu)建通用且泛化的操作策略一直是機器人領(lǐng)域的核心目標。傳統(tǒng)的機器人學(xué)習(xí)方法通常針對特定機器人和任務(wù)來開發(fā)模仿學(xué)習(xí)算法,例如ACT和Diffusion Policy,這些方法在特定場景中表現(xiàn)出色,但在泛化能力上較為有限。隨著機器人在開放、多任務(wù)環(huán)境中的應(yīng)用增加,能夠適應(yīng)不同任務(wù)和機器人構(gòu)型的系統(tǒng)需求也在上升,這促使了通用模型的發(fā)展,如RT-2和OpenVLA等。這些模型通過大規(guī)模、異構(gòu)的數(shù)據(jù)集提升跨域泛化能力,旨在將普遍知識融入到機器人控制中。


        雖然基于 VLA 的通用策略在不同場景中表現(xiàn)出很強的泛化性,但其仍存在一些局限:


           ·目前預(yù)訓(xùn)練好的模型仍不具備zero-shot的遷移能力,而對現(xiàn)有大模型直接微調(diào)需要足夠的訓(xùn)練數(shù)據(jù)和算力。因此我們需要更高效的路徑來快速適配(adapt)到新場景或新機器人本體;


           ·以O(shè)penVLA為例,這類大模型的參數(shù)量龐大,并以自回歸的方式預(yù)測每個自由度的動作輸出,推理延遲高(<5Hz),很難對一些動態(tài)場景做實時響應(yīng),也難以實現(xiàn)需要精細位置控制的操作任務(wù);


           ·當前的通用模型僅能處理單幀的 RGB 輸入,雖然這允許它們可以通過更大規(guī)模的(非機器人操作)數(shù)據(jù)集進行訓(xùn)練,但在深度信息或觸覺反饋等額外傳感器輸入對機器人操作任務(wù)至關(guān)重要的情況下,很難靈活擴展輸入模態(tài)以提高性能。


221.jpg

RoboDual整體框架結(jié)構(gòu)


        我們發(fā)現(xiàn),在具身走向通用的路徑中,專用策略(Specialist Policy)低延遲、高精度、訓(xùn)練高效的特點剛好可以彌補當前通用模型(Generalist Policy)的劣勢,于是團隊提出了RoboDual工作,將Generalist的泛化能力和Specialist的精準高效結(jié)合到一個協(xié)同工作框架中,不僅在操作時的精度更高、延遲更低,還具備更強的場景、指令的泛化能力,同時對于單個任務(wù)或場景的微調(diào)更加高效。


222.jpg

RoboDual模型框架


        RoboDual中的Generalist部分參考基于Prismatic-7B VLM的OpenVLA架構(gòu),以觀察的視頻幀與指令作為輸入,自回歸地生成action latents及相應(yīng)的離散動作輸出,并將其傳到下游Specialist模型作為condition;Specialist部分采用可擴展的Diffusion Transformer (DiT)架構(gòu),接收多種傳感器(如RGB相機)輸入的同時,將Generalist的輸出作為參考,經(jīng)過去噪得到未來幾步的連續(xù)動作。


        同時,由于Generalist與Specialist的輸出頻率不同,為保證較低的控制延遲,Generalist與Specialist實行異步控制(即Generalist輸出一步時,Specialist輸出多步),在較慢,但更魯棒的Generalist輸出指引下,實現(xiàn)順滑且靈巧的動作控制。在真機實驗中,我們采用NVIDIA RTX 5000 Ada GPU進行推理,RoboDual可以實現(xiàn)15Hz的控制頻率。


        在大量仿真(CALVIN)及真機的實驗發(fā)現(xiàn),RoboDual均領(lǐng)先現(xiàn)有的Generalist和Specialist模仿學(xué)習(xí)方法,可以利用僅5%的數(shù)據(jù)實現(xiàn)任務(wù)和場景的高效適配。此外我們在真機實驗中還設(shè)計了眾多泛化場景,RoboDual在不失推理效率的同時實現(xiàn)了更優(yōu)的泛化性能。


224.jpg
223.jpg

真機任務(wù)及泛化實驗


        通過將RoboDual與OpenVLA進行對比,可見RoboDual在同樣的泛化場景中保持了明顯更低的推理延遲。至此,RoboDual提供了一個讓通用操作大模型廣泛落地應(yīng)用的解決方案。


真機推理效率對比(與OpenVLA)


        星空真人機器人與上海人工智能實驗室共同研發(fā)的RoboDual系統(tǒng),不僅提供了一個讓通用操作大模型廣泛落地應(yīng)用的解決方案,更為機器人技術(shù)的未來發(fā)展指明了方向。隨著RoboDual系統(tǒng)的不斷完善和應(yīng)用,我們希望它能為機器人操作領(lǐng)域帶來更高效、更精準、更智能的未來。